
FlinkとKafka Streamsの状態コスト比較、障害復旧と遅延差が示す選定論点
公開日:2026年9月26日

3行解説
- FlinkとKafka Streamsを、Kafka上のexactly-once処理で比較した論文です。
- 状態の持ち方が異なり、遅延や障害時の復旧結果に差が出ました。
- 正しさだけでなく、完了率と復旧時間まで見る必要があると示しています。
ニュースの概要
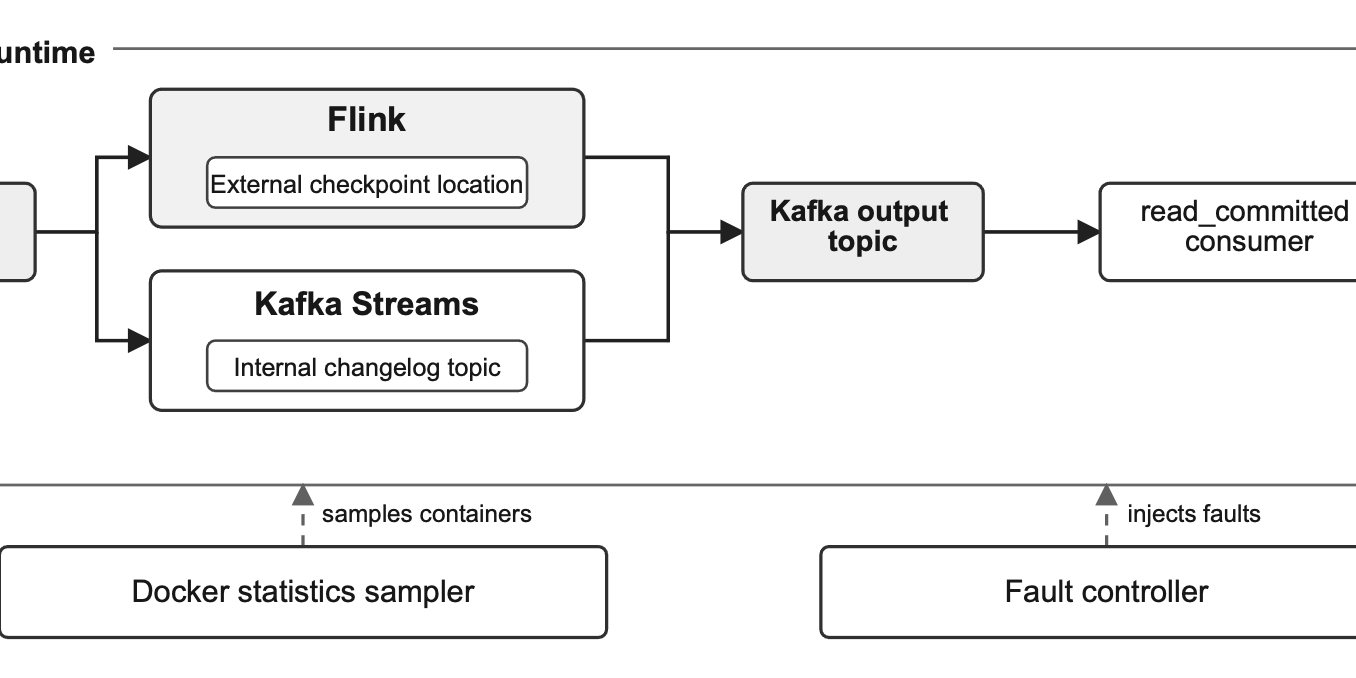
arXivに2026年9月23日付で投稿された論文「Where Does Streaming State Cost Go?」は、Apache FlinkとKafka Streamsの2つのストリーミング処理エンジンを、Kafka上のexactly-onceパイプラインとして比較したものです。著者はKiran N Kumar氏とSanthosh Kumar Saminathan氏です。論文では、Flinkは外部ストレージへのcheckpointで状態を管理し、Kafka Streamsはbrokerのchangelogを再生してローカル状態を復元する点に着目しています。
実験では、正しさ、遅延、資源消費、設定変更への感度、障害注入後の復旧を評価しました。50回の正しさ試験では期待通りの出力が確認されましたが、30分試験では処理内容によって遅延差が出ました。さらに、durability intervalを1,000msから10,000msに変えたときの挙動や、JVM停止やローカルボリューム喪失を入れた場合の完了率も調べています。
何が新しいのか
この論文の新しさは、exactly-onceの「正しく処理できるか」だけでなく、状態管理の方式が遅延と復旧にどう効くかを、同じKafka上で比較した点にあります。Flinkは外部ストレージのcheckpoint、Kafka Streamsはローカル状態の再構築という違いがあるため、障害時のふるまいが単純には同じになりません。
測定結果では、100 events/secの30分試験で、stateless workloadの ingestion to output interval は4〜6ms、windowed workloadでは4.3〜6.2秒でした。p99もstatelessで1.97秒、windowedで5.68〜9.92秒と差が出ています。さらに、durability intervalを1,000msから10,000msに上げると、Kafka StreamsのW3 median p99 T2-T1は6,085msから23,155msへ、FlinkのT3-T2は732msから8,702msへ変化しました。
外部checkpoint
ローカル復元
同じKafkaでも、状態の置き方で性能と障害時の挙動が変わることを整理した図です。
グリットアーツ編集部の分析
実務上のポイントは、正しさの確認だけでは導入判断にならないことです。論文では、Kafka Streamsがstateful JVM-kill試験で0/5、stateful local-volume-loss試験で1/5しか完了しなかった一方、Flinkは同条件で5/5完了しました。これは、障害が起きたときに「処理が再開するか」だけでなく、「最後まで完了できるか」を見ないと、運用設計を誤る可能性があることを示します。
また、設定値の変更で遅延分布が大きく動いているため、チューニング余地がある反面、変更管理を厳しくしないと本番で想定外の遅延が出る可能性があります。ストリーミング基盤を選ぶ際は、単体性能よりも、復旧時間、障害時のデータ欠損リスク、監視で追うべき指標をセットで決める必要があります。
日本の現場で考えると
日本企業でこの種の基盤を使う場合、まず確認したいのは、下流システムが数秒の遅延を許容できるかどうかです。論文ではwindowed workloadで秒単位の遅延が出ており、リアルタイム性を前提にした通知、在庫更新、監視連携では影響が大きくなります。一方、集計や後追い分析のように多少の遅れを許容できる用途では、設計の自由度が高くなります。
また、Kafka Streamsはローカル状態の復元に依存するため、サーバー障害やディスク障害時の運用をどう組むかが重要です。Flinkは外部ストレージのcheckpointを使うため、今度は外部ストレージ側の安定性や容量、復旧手順が論点になります。どちらを選ぶ場合でも、アプリケーションだけでなく、OS、ディスク、ストレージ、Kafkaクラスタまで含めた保守設計が必要です。
導入・検討時に確認したいこと
- 障害復旧時に、どの状態をどこから復元する設計か。
- ローカルディスク障害やJVM停止時に、処理が最後まで完了するか。
- durability intervalなどの設定変更で、遅延がどの程度変動するか。
- 100 events/sec級の負荷で、statelessとwindowedの両方を試したか。
- 監視対象を、正しさだけでなくp99遅延と完了率まで含めるか。
現時点で分かっていないこと
この情報だけでは、実運用での必要CPU・メモリ・ストレージ容量は分かりません。また、試験環境の詳細な構成、Kafkaクラスタの規模、ネットワーク条件も不明です。どの業務要件ならFlinkとKafka Streamsのどちらが適切かは、個別のSLAと障害許容度を見て判断する必要があります。
ストリーミング基盤は、正しさだけでなく遅延や復旧の見え方まで含めて設計する必要があります。既存のサーバーや運用体制に合わせた見直しを進めるなら、インフラ全体の観点で整理することが重要です。
ITインフラの構築・保守をご検討の方へ
「自社の環境にはどんな構成・保守体制が合うのか」お悩みではありませんか。貴社の現場課題に合わせたご提案をいたします。まずはご相談からお気軽にどうぞ。
出典: arXiv (cs.DC)