
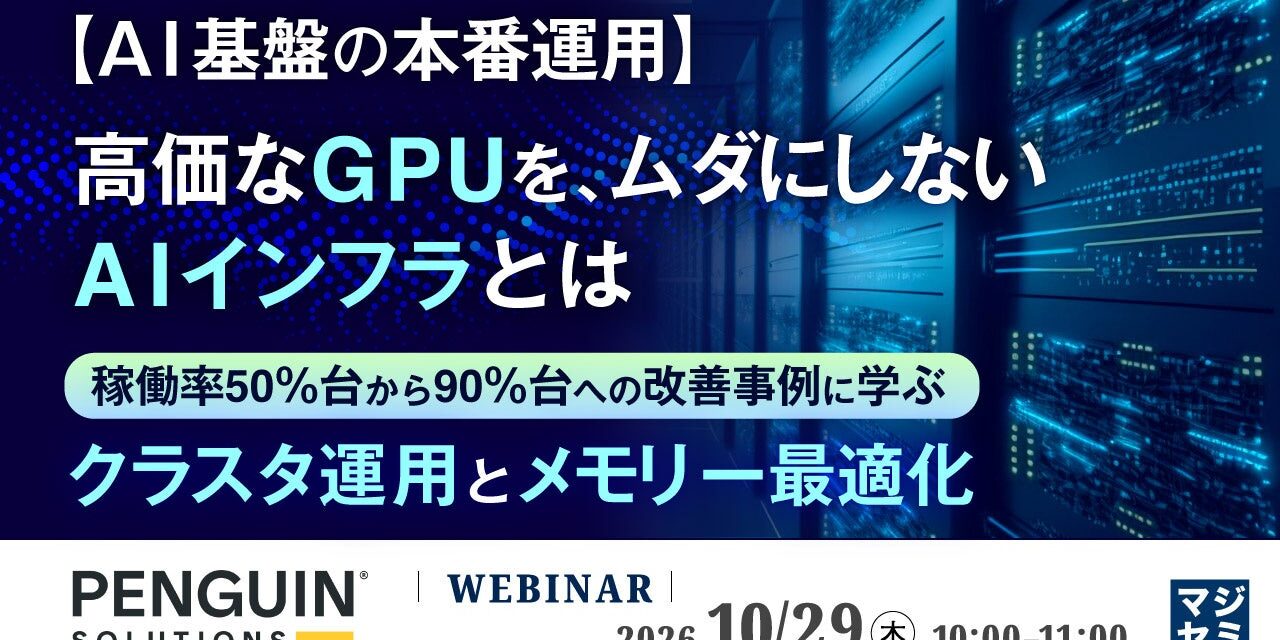
ペンギンソリューションズがAI基盤運用のウェビナー開催 GPU稼働率とKVキャッシュ最適化を解説
公開日:2026年10月11日
3行解説
- ペンギンソリューションズが、AI基盤の本番運用をテーマにしたウェビナーを開催します。
- GPU稼働率を50%台から90%台へ引き上げた事例と、KVキャッシュ最適化を紹介します。
- サーバー、ストレージ、ネットワーク、監視・保守まで含めた運用の考え方が焦点です。
ニュースの概要
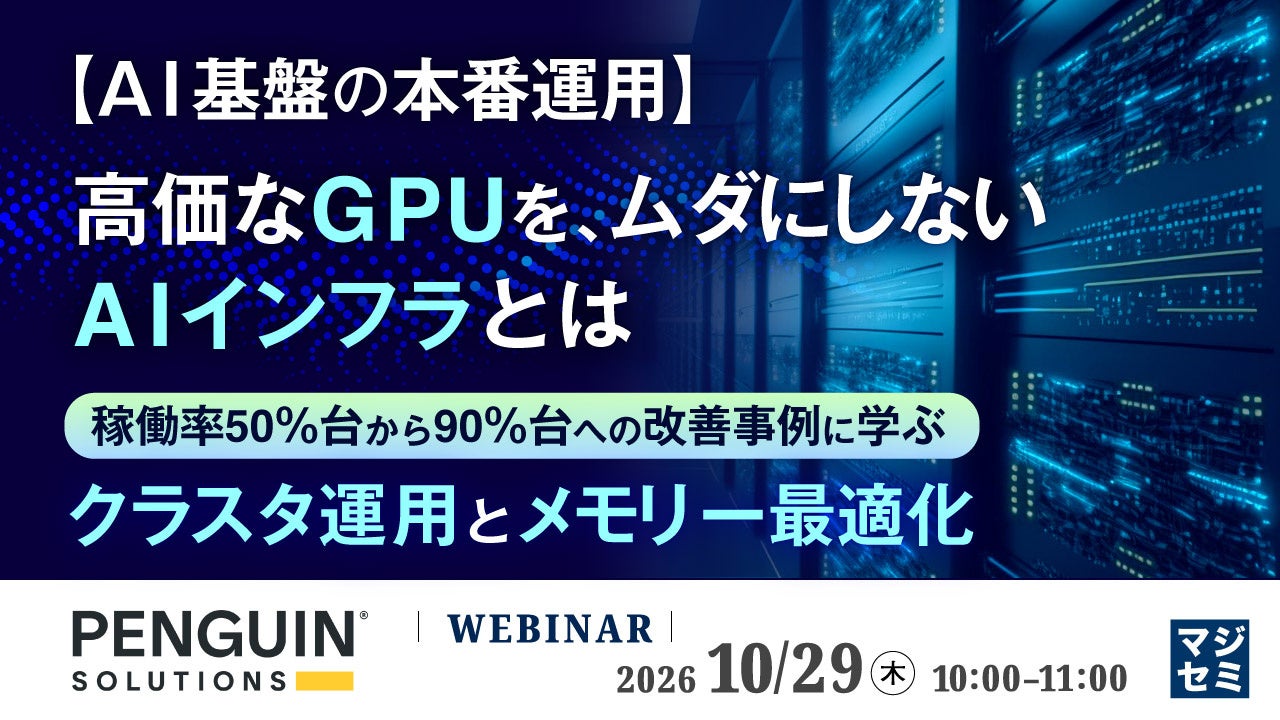
マジセミ株式会社は2026年10月9日、ペンギンソリューションズ株式会社が「【AI基盤の本番運用】高価なGPUを、ムダにしないAIインフラとは」というテーマのウェビナーを開催すると発表しました。対象は、AIインフラを構築・運用する企業や、GPUクラウド事業者、自社環境でのLLM学習・推論への移行を検討する企業です。案内では、GPU投資を成果につなげるには、設備を増やすだけでなく安定運用と性能の引き出し方が重要だとしています。
何が新しいのか
このウェビナーの新しさは、GPUを「増やす話」ではなく、稼働率と推論時のメモリー制約をどう詰めるかに焦点を当てている点です。案内では、クラスタの安定運用とパフォーマンス最適化を支援する「ClusterWareAI」と、KVキャッシュを大容量メモリーへ移してGPUメモリー負荷を軽減する「MemoryAI KV Cache Server」を紹介するとしています。
また、GPU稼働率を50%台から90%台へ引き上げた過去の実績をもとに、設計・構築・運用で何を見直したかを事例として扱う点も特徴です。単なる製品説明ではなく、障害時のジョブ中断、復旧、再実行、そして推論時のメモリー不足まで含めて、基盤全体の運用を整理する内容になっています。
案内文で示された論点を、投資から運用改善までの流れとして整理した図です。
グリットアーツ編集部の分析
注目すべきは、GPU稼働率を50%台から90%台へ引き上げたという具体的な改善事例です。AI基盤では、GPUを追加しても、障害対応や再実行の遅れ、推論時のメモリー不足が残ると投資効果が出にくいからです。今回の案内は、性能向上だけでなく、運用設計そのものを見直す必要があることを示しています。
一方で、紹介されるのはあくまでウェビナーであり、導入条件や対応範囲はまだ見えません。実運用では、GPU単体の性能よりも、サーバー、ストレージ、ネットワーク、監視のどこがボトルネックになるかを切り分けられるかが重要です。そこを確認できれば、増設前に改善できる余地があるか判断しやすくなります。
日本の現場で考えると
日本の企業でAI基盤を本番運用する場合、まず気になるのは既存環境との接続です。オンプレミスのサーバー室やデータセンターでは、GPUを増やすだけでなく、ネットワーク帯域、ストレージ性能、監視体制を同時に見直さないと、処理待ちが増える可能性があります。
また、長い文章を扱う推論や同時リクエストが多い用途では、GPUメモリー不足が起きやすいと案内されています。したがって、向いているのは、LLM学習・推論を自社で継続運用したい企業や、GPUクラウド事業者のように稼働率が収益に直結する用途です。逆に、負荷が小さく、障害時の停止影響も限定的な用途では、ここまでの運用最適化が過剰になる可能性があります。
導入・検討時に確認したいこと
- GPU稼働率の改善を、どの指標で測るのか。平均稼働率だけでなく、障害時の停止時間や再実行時間も見る必要があります。
- 「ClusterWareAI」と「MemoryAI KV Cache Server」が、既存のGPUサーバー、ストレージ、ネットワークとどう接続するのか。
- KVキャッシュを大容量メモリーへ移す方式で、どの程度メモリー負荷を下げられるのか。対象となる推論条件も確認が必要です。
- 監視・保守の範囲がどこまで含まれるのか。障害切り分けの責任分界も事前に整理したいところです。
- クラウド利用から自社環境へ移る場合、切り替え時の停止時間や運用体制の変更がどれだけ必要かを確認すべきです。
現時点で分かっていないこと
案内文だけでは、対応GPUの種類、具体的な構成、導入条件は確認できません。また、監視方式や保守範囲、どの規模の環境で効果が出やすいかも不明です。実際の採用判断では、既存基盤との互換性と運用分担を個別に確認する必要があります。
GPUを増やす前に、今ある基盤でどこまで性能と稼働率を引き出せるかを見極めることが重要です。AI基盤の設計や運用でお困りなら、既存環境の整理からご相談ください。
ITインフラの構築・保守をご検討の方へ
「自社の環境にはどんな構成・保守体制が合うのか」お悩みではありませんか。貴社の現場課題に合わせたご提案をいたします。まずはご相談からお気軽にどうぞ。
出典: PR TIMES