
CyberAgentがLangfuse停止時に備えたプロンプト配布設計を公開
公開日:2026年10月20日
3行解説
- CyberAgentが、セルフホストLangfuseの停止に備える配布設計を公開しました。
- Cloud Runのオートスケール環境では、起動時取得だけではスケールアウト不能になる課題があります。
- プロンプトをオブジェクトストレージへミラーし、停止時だけそこから読む構成を採りました。
ニュースの概要
CyberAgent Developers Blogは2026年10月18日、セルフホストしているLangfuseのプロンプト配布を、オブジェクトストレージへミラーする運用について公開しました。執筆者はAI事業本部 AIクリエイティブカンパニー BPO事業部のエンジニアです。記事では、LLMを使ったチャット機能を提供するサービスで、Langfuseのアップグレードや障害時にもプロンプト配布を止めない必要があったと説明しています。
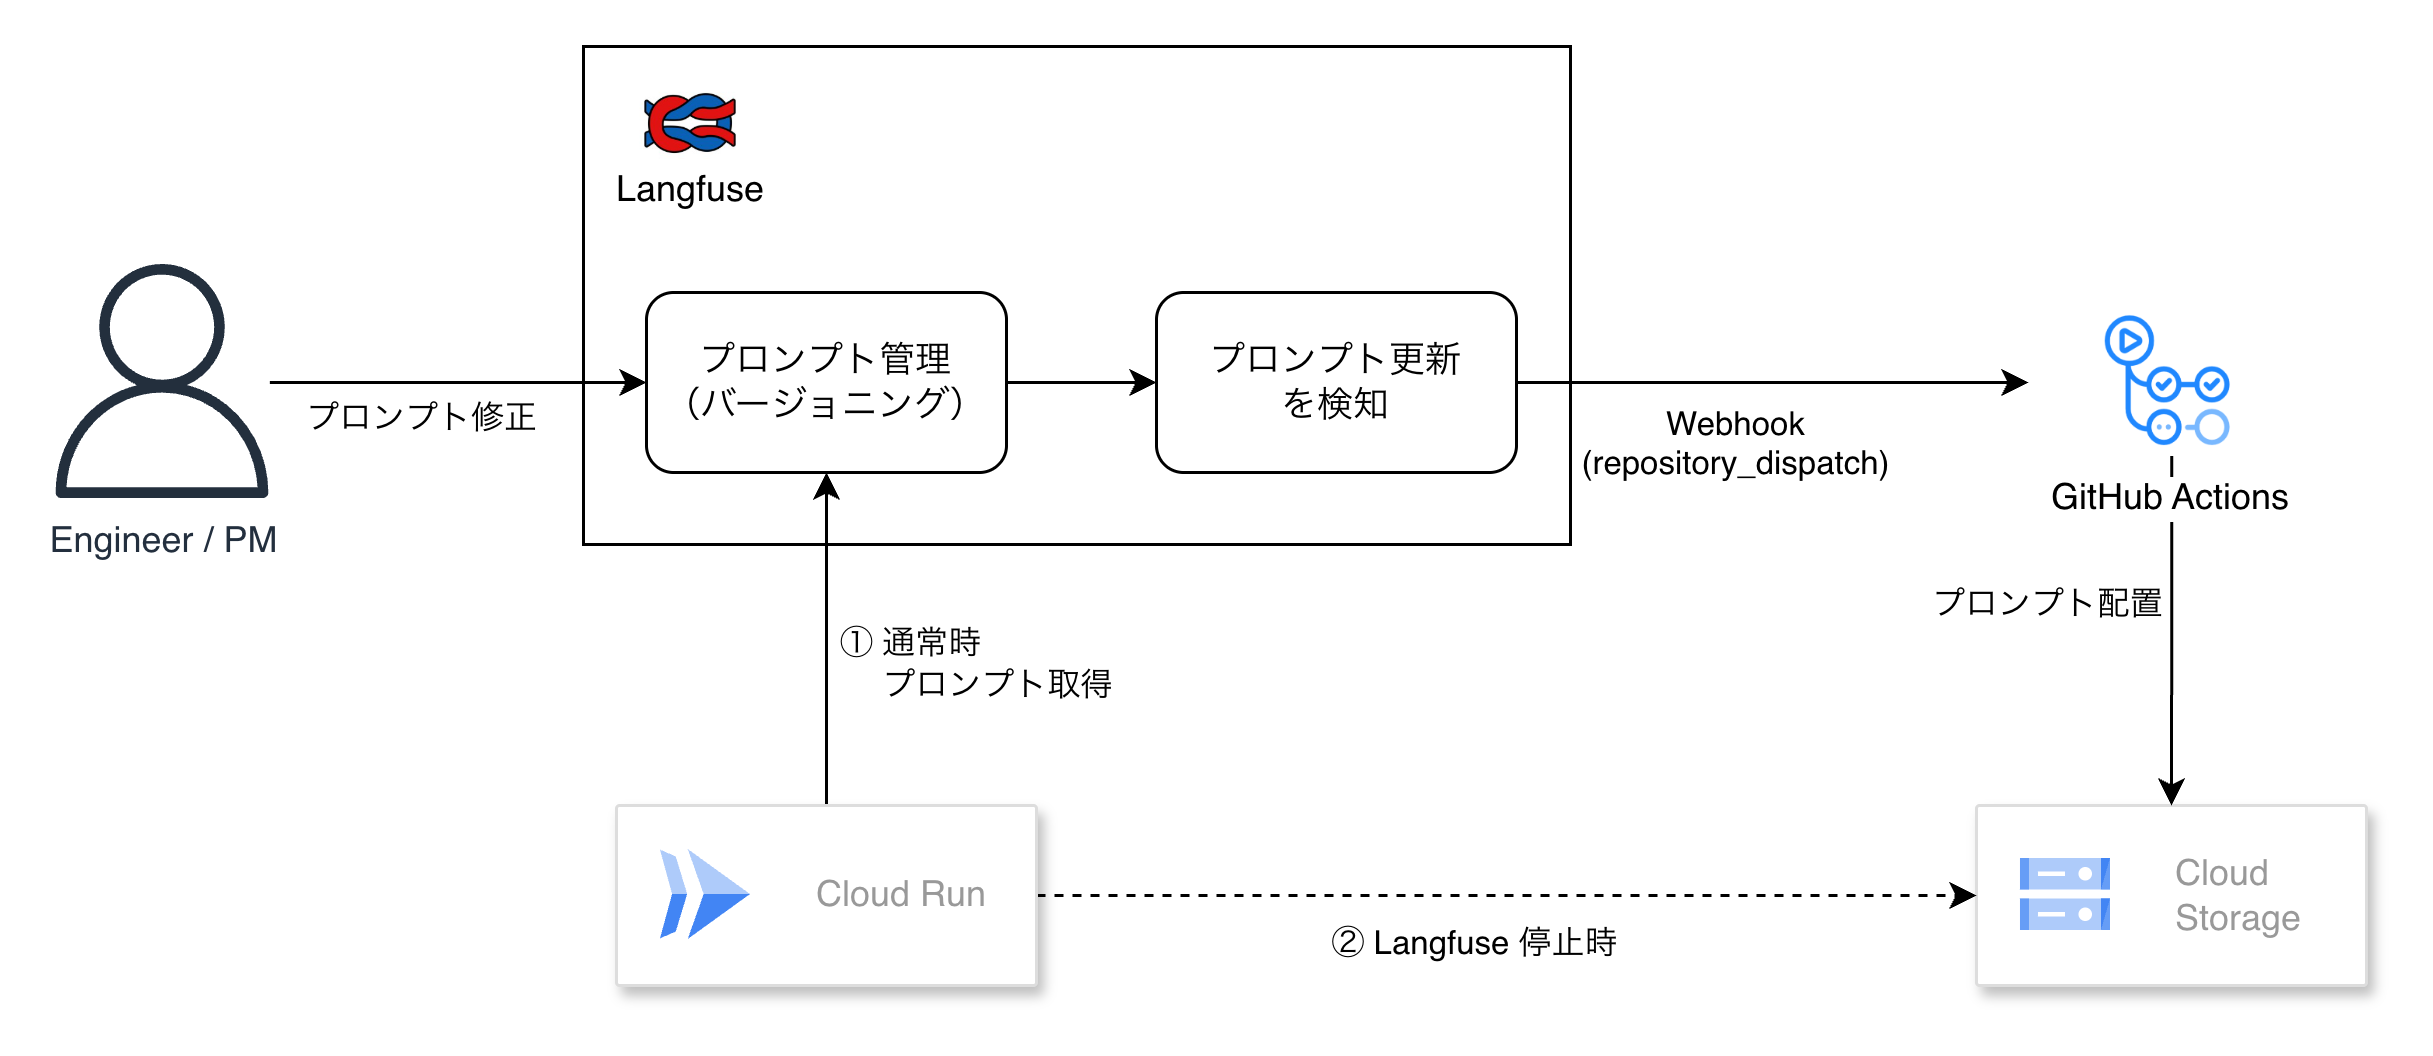
同社は、Langfuseの公式案として紹介される起動時のpre-fetchやfallbackを検討したうえで、自社の運用には合わないと判断しました。その代わりに、Langfuseで更新されたプロンプトを自動でオブジェクトストレージへコピーし、Langfuseが止まったときだけそこから取得する構成を採用したとしています。
何が新しいのか
新しい点は、Langfuseを唯一の参照先にしないことです。記事では、Langfuseで新しいバージョン作成やラベル変更が起きると、GitHub Actionsが各環境向けのプロンプトを取得し、オブジェクトストレージへ配置する流れを示しています。これにより、普段はLangfuseを使いながら、停止時にはストレージ側へ切り替えられます。
従来案との違いも明確です。起動時pre-fetchは、固定台数のVMなら成立しやすい一方、Cloud Runのようにインスタンスが増減する環境では、新規起動時にLangfuseへ届かないとスケールアウトできません。fallbackはデプロイ不要で動くものの、コード内の古いプロンプトが残りやすく、修正内容が停止時に反映されない問題があります。
通常時はLangfuseを優先し、停止時にストレージ側を参照する考え方です。
グリットアーツ編集部の分析
この事例で重要なのは、「可観測性ツールの停止」と「本番機能の停止」を切り離そうとしている点です。Langfuseが止まるとチャット機能まで止まる構成では、監視や管理のための基盤が業務停止の原因になります。オブジェクトストレージへのミラーは、その依存関係を弱める実装として現実的です。
一方で、これは単なるバックアップではありません。更新のたびにミラーを同期し、停止時だけ切り替えるため、整合性の確認と切替条件の設計が必要です。特にオートスケール環境では、起動失敗がそのまま処理能力不足につながるため、運用設計まで含めて考えないと効果が出にくいとみられます。
日本の現場で考えると
日本企業でこの構成を検討するなら、まずサーバレスやオートスケール前提のLLMサービスに向いています。リクエスト増加時に新しいインスタンスが立ち上がるため、依存先が止まった瞬間に起動できない設計は避けたいからです。逆に、固定台数で長時間動くVM中心の環境なら、pre-fetchでも成立する余地があります。
慎重に見るべきなのは、プロンプト更新の頻度が高い現場です。コードに埋め込むfallbackだと、停止時に古い内容へ戻る可能性があります。日本の本番運用では、障害時の切替先、環境ごとの分離、更新反映の遅れをどう扱うかを先に決めておく必要があります。
導入・検討時に確認したいこと
- Langfuse更新からストレージ反映までの遅延はどの程度か。
- Langfuse停止時に、どの条件でストレージ側へ切り替えるか。
- 環境ごとにバケットや保存先を分ける運用が可能か。
- プロンプト本文だけでなく、LLMパラメータも同時に管理できるか。
- オートスケール時の新規起動で、取得失敗が起きた場合の挙動はどうなるか。
現時点で分かっていないこと
記事からは、ミラー更新の具体的な遅延時間や、障害時の自動切替条件の詳細は分かりません。また、どのオブジェクトストレージを使ったか、運用コストがどの程度増えるかも明示されていません。
LLM基盤では、可観測性ツールの停止がそのまま本番影響につながることがあります。自社の運用でも、依存先停止時の切り替え方を先に決めておくことが重要です。
ITインフラの構築・保守をご検討の方へ
「自社の環境にはどんな構成・保守体制が合うのか」お悩みではありませんか。貴社の現場課題に合わせたご提案をいたします。まずはご相談からお気軽にどうぞ。