
MoE推論を3D積層NMPで高速化する「3D-MoE」 負荷偏りと帯域不足にどう向き合うか
公開日:2026年10月22日
3行解説
- arXivで、MoE推論を3D積層DRAM近傍処理で高速化する手法が公開された。
- 負荷偏りを前提に、事前グルーピングとオンライン再配置を組み合わせている。
- 平均4.63倍のMoE層高速化と、2.11%の追加ロジック面積が示された。
ニュースの概要
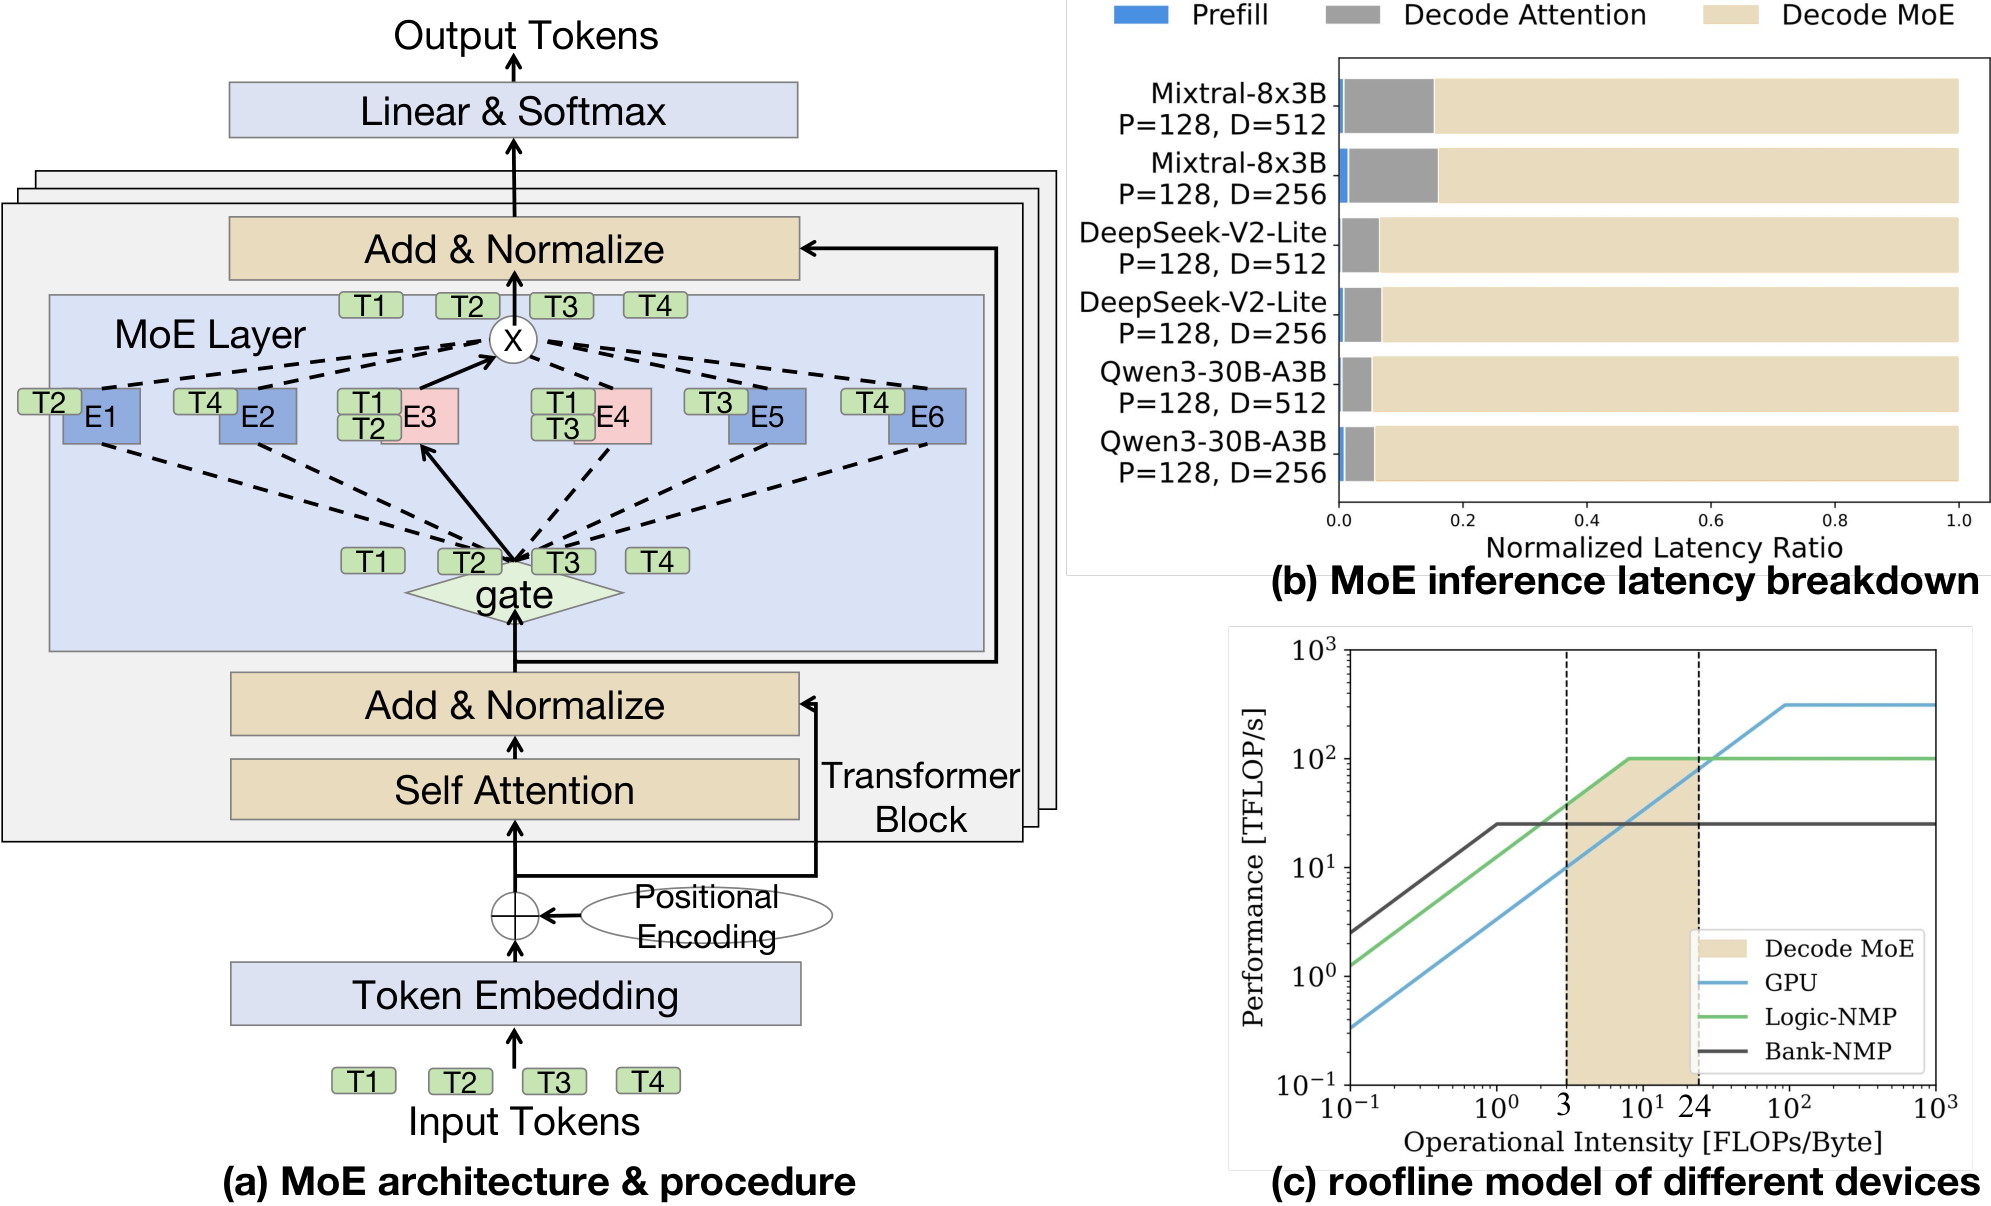
arXivに2026年10月19日付で、Yudong Pan氏らによる論文「3D-MoE: Complementarity-Guided Hardware-Software Co-Design for MoE Decode on 3D-Stacked NMP」が掲載されました。対象は、Mixture-of-Experts(MoE)を使う大規模言語モデルのデコード処理です。論文では、3D積層DRAMを使う近傍処理(NMP)上で、MoE推論のメモリ帯域不足と専門家ごとの負荷偏りをどう抑えるかを扱っています。
提案手法の3D-MoEは、専門家の負荷が時間的にずれる性質を利用し、オフラインのグルーピング、局所性を意識した配置、軽量なCollaborative Memory-Network(CMN)、コストを考慮したオンライン再配置を組み合わせています。論文では、MoE層で平均4.63倍の高速化、エンドツーエンドのスループットで1.58倍から1.86倍の改善、追加のロジックダイ面積は2.11%としています。
何が新しいのか
新しい点は、MoE推論の「速くしたいが、負荷が偏ると逆に詰まる」という問題に対し、ハードウェアとソフトウェアを一体で設計していることです。論文は、3D積層DRAMが帯域を提供できる一方で、タイル化された構成では負荷分散が難しいと整理しています。そこで、まずオフラインで専門家をまとめて配置し、残る偏りはCMNで補い、さらにワークロードの変化に応じて再配置します。
偏りを完全に消すのではなく、事前設計と運用時の調整で吸収する構成です。
論文中の数値も、単なる理論提案ではなく実装上のトレードオフを示しています。MoE層で4.63倍の高速化がある一方、追加面積は2.11%に抑えられています。つまり、性能向上の余地は大きいものの、実際の採用では「どの程度の面積増や設計変更を許容できるか」が判断材料になります。
グリットアーツ編集部の分析
この論文で重要なのは、MoE decodeはmemory-boundで、しかも専門家の負荷が時間変動すると明示している点です。AI基盤の現場では、GPUの演算性能だけを上げても、メモリ階層やデータ配置が合わなければ期待したスループットは出ません。3D-MoEは、そのボトルネックを「帯域」と「偏り」の両方から扱っているため、推論基盤の設計検討では有効な比較対象になります。
一方で、提案は3D積層DRAMとNMPという前提があるため、既存の一般的なGPUサーバーにそのまま当てはめる話ではありません。導入判断では、対象モデルのルーティング偏りがどれだけ強いか、推論ステップごとの負荷変動がどの程度あるかを見ないと、効果が再現しにくい可能性があります。性能向上と2.11%の面積増のバランスを、電力や筐体制約も含めて評価する必要があります。
日本の現場で考えると
日本のAI基盤運用では、同じMoEモデルでも、問い合わせ内容や時間帯で負荷が変わるケースがあります。こうした環境では、オフラインで一度決めた配置だけでは足りず、オンライン再配置の運用負荷がどこまで許容できるかが論点になります。逆に、推論パターンが比較的安定している用途なら、事前グルーピングの効果を活かしやすいと考えられます。
慎重に見るべきなのは、モデル更新が頻繁で、ワークロードの偏りが読みにくい現場です。再配置のたびに性能が安定するとは限らず、検証や監視の手間が増える可能性があります。また、3D積層DRAMやNMPを前提にするため、既存のサーバー更新計画や調達方針と整合するかも確認が必要です。
導入・検討時に確認したいこと
- 対象MoEモデルで、専門家の呼び出し偏りがどの程度あるか。
- 推論ステップごとの負荷変動に対して、再配置がどこまで効くか。
- 3D積層DRAMやNMPを前提にした場合の、既存基盤との互換性。
- 追加ロジック面積2.11%に相当する電力・筐体・コストの影響。
- オンライン再配置を運用する際の監視項目と切り替え条件。
現時点で分かっていないこと
論文要約からは、実機の製品化時期や対応する具体的なハードウェア構成は分かりません。また、どの種類のMoEモデルでどこまで再現性があるか、運用時の再配置コストがどの程度かも限定的です。日本の現場で使う場合の保守性や障害時の切り戻し手順も、本文だけでは確認できません。
MoE推論のように、モデル特性とメモリ階層の相性で性能が大きく変わる基盤では、事前検証の設計が重要です。自社のAI基盤でどこがボトルネックになりやすいかを整理したい場合は、構成検討の観点からご相談ください。
ITインフラの構築・保守をご検討の方へ
「自社の環境にはどんな構成・保守体制が合うのか」お悩みではありませんか。貴社の現場課題に合わせたご提案をいたします。まずはご相談からお気軽にどうぞ。
出典: arXiv (cs.AR)