
LLM推論のprefill/decodeを別並列で同時実行、ConfluxServeがgoodput改善を主張
公開日:2026年10月31日
3行解説
- LLM推論のprefillとdecodeを、同じバッチ内で別の並列化で動かす方式を提案した論文です。
- TTFTとTBTの制約を守りながら、クラスタ全体のgoodputを高めることを狙っています。
- production workloadsで、強い比較対象より1.26〜1.62倍のgoodput改善を報告しています。
ニュースの概要
arXivに2026年10月27日付で投稿された論文「ConfluxServe」は、LLM servingにおけるprefillとdecodeの扱いを見直す研究です。著者はWenhao Chen氏とHong Zhang氏の2人です。論文は、prefillとdecodeが必要とする資源の使い方は補完的だが、並列化の好みは異なると整理しています。そのうえで、TTFTとTBTの制約を意識しながら、クラスタ全体のgoodputを最大化するサービング方式を提案しています。
何が新しいのか
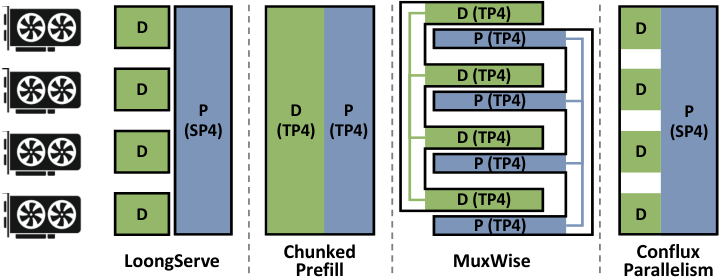
従来は、prefillとdecodeを別々に実行すれば各フェーズに合った並列化を保てますが、空いている資源が残りやすくなります。逆にco-batchingでは資源利用率は上がる一方、同じ並列設定を前提にしやすく、実行効率が落ちることがありました。ConfluxServeは、この二つの弱点を同時に抑えるために、同一バッチ内でprefillとdecodeを異なる並列化で共実行するConflux Parallelism(XP)を導入しています。
論文が示す課題は、資源利用率と並列効率の両立です。
論文では、Transformerのオペレータ構造を使って異種の実行経路を組み立てると説明されています。つまり、単にバッチをまとめるのではなく、処理の段階ごとに異なるバッチングや並列戦略を使う点が新しいところです。さらに、これをSLO-aware servingとしてまとめ、TTFTとTBTの制約下でgoodputを最大化する設計にしています。評価では、production workloadsで1.26〜1.62倍のgoodput改善が示されています。
グリットアーツ編集部の分析
この論文で重要なのは、「GPUをどれだけ使い切るか」だけでなく、「TTFTとTBTを守ったままどれだけ処理できるか」を同時に見ている点です。LLM基盤では、平均スループットが高くても、初回応答が遅いと業務利用では使いにくくなります。ConfluxServeは、prefillとdecodeの並列化を分けることで、その矛盾を減らそうとしています。既存の一様な並列設定で十分な環境より、負荷の波があり、応答品質の制約も厳しい環境で価値が出やすいとみられます。
一方で、論文が示すのは研究評価であり、実運用ではワークロードの偏りやモデルサイズ、GPU構成によって効果が変わる可能性があります。したがって、導入判断では「性能が上がるか」だけでなく、「運用の複雑さを増やしてでも採る価値があるか」を見る必要があります。特に、推論基盤の増強余地が限られる企業ほど、同じGPU群で収容できるリクエスト数やコスト当たり性能に直結するため、投資判断の材料になりやすい内容です。
日本の現場で考えると
日本の企業でLLMを本番利用する場合、重要なのは単純なベンチマークよりも、業務時間帯の混雑や問い合わせの偏りに耐えられるかです。prefillとdecodeを別々に最適化できる設計は、チャット、社内検索、文書要約のように、入力長と出力長がばらつく用途で検討しやすいです。反対に、応答遅延の上限が非常に厳しい業務や、運用チームが複雑な並列設定を管理しにくい環境では、慎重な評価が必要です。
また、既存のGPUクラスタにそのまま載せ替えられるかは別問題です。バッチ構成や並列設定が変わると、監視項目、障害切り分け、性能劣化時の原因特定も変わります。日本の現場では、モデル更新やピーク時の増減に合わせて、どこまで自動で制御できるかが実装上の論点になります。
導入・検討時に確認したいこと
- TTFTとTBTを、実運用のトラフィックでどの程度維持できるか。
- 既存の一様並列設定やco-batchingと比べたときのGPU利用率とgoodputの差。
- prefillとdecodeで異なる並列化を使う際の設定変更や運用負荷。
- モデルサイズや入力長の違いで効果がどこまで再現するか。
- 障害時や負荷急増時に、従来方式へ戻す運用が可能か。
現時点で分かっていないこと
論文要約からは、どのGPU構成やモデル群で最も効果が出たのかは分かりません。また、実運用での制御の複雑さ、既存サービング基盤との互換性、導入に必要な追加実装の範囲も不明です。goodput改善がどの程度の運用条件で再現するかも、本文だけでは判断できません。
LLM推論基盤では、性能だけでなくTTFTやTBTのような運用品質指標まで含めた設計が重要です。既存GPU基盤の見直しやPoCの進め方を整理したい場合は、運用前提での検討が役立ちます。
ITインフラの構築・保守をご検討の方へ
「自社の環境にはどんな構成・保守体制が合うのか」お悩みではありませんか。貴社の現場課題に合わせたご提案をいたします。まずはご相談からお気軽にどうぞ。
出典: arXiv (cs.DC)