
HPCテレメトリを解釈可能にするINSIGHT-HPC、異常の切り分けを支援
公開日:2026年11月5日
3行解説
- HPC向けに、BMC・スケジューラ・PDUのテレメトリをまとめて異常検知する手法が示された。
- 単なる統計的なズレではなく、ワークロード要因と設備異常を切り分ける設計が特徴。
- 評価ではprecision 0.913、recall 0.817、F1 0.862、AUROC 0.896を示した。
ニュースの概要
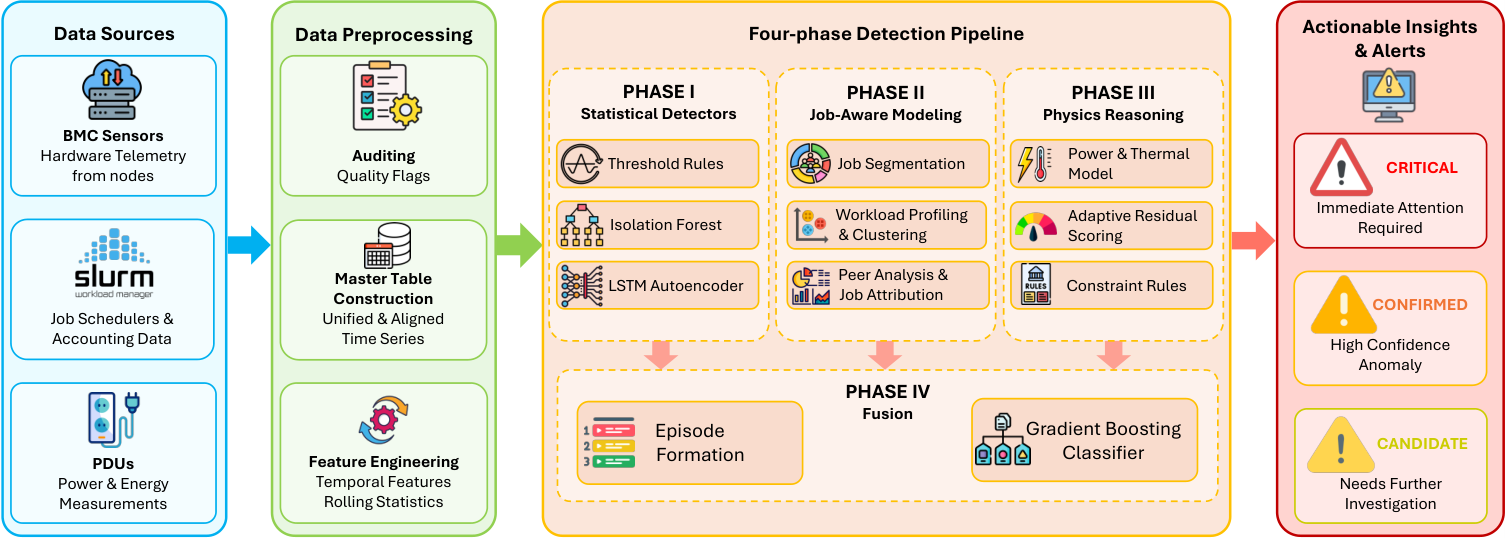
2026年11月2日、Rupak Kadel氏らは、HPCクラスタ向けの異常検知手法「INSIGHT-HPC」をarXivで公開しました。対象は、世代の異なるCPUとGPUを混在させた高性能計算環境です。論文では、BMC(ベースボード管理コントローラ)、ジョブスケジューラ、施設側のPDU(電源分配装置)から得られるテレメトリを統合し、運用者が読める形の異常エピソードにまとめる方法を提案しています。IEEE BigData 2026で採択されたと記載されています。
何が新しいのか
新しい点は、異常を「数値の外れ値」として見るだけでなく、ワークロードで説明できる変動と、本当に設備側の異常とみるべき兆候を分けて扱うことです。さらに、分単位のノイズの多い観測を、そのまま大量のアラートにせず、重複を除いたfault episodeとしてまとめています。これにより、運用者が原因を追いやすい形に変換する設計になっています。
分散した観測を、現場で扱いやすい単位にまとめる流れを示している。
評価では、弱い運用ラベルしかない実運用データと、HPC向けの故障注入を使っています。これは、ラベルが十分にそろわない現場でも使えるかを意識した検証です。単に検知率を競うのではなく、運用現場で「何が起きたか」を説明できることを重視している点が、従来の監視ツールとの差になっています。
グリットアーツ編集部の分析
この論文で重要なのは、precision 0.913、recall 0.817という数値そのものより、BMC・ジョブスケジューラ・PDUをまたいで判断する設計です。HPCでは、計算負荷の上昇がそのまま異常とは限らず、ワークロード由来の変動を誤検知すると運用負荷が増えます。逆に、設備側の兆候を見逃すとノード故障や電力の無駄につながります。説明可能なエピソード化は、アラートを受けた担当者が次に何を見るべきかを絞りやすくするため、実運用での価値が出やすいとみられます。
日本の現場で考えると
日本のHPCや研究機関、製造業の計算基盤では、監視対象がサーバーだけでなく電源やジョブ管理まで広がることがあります。この手法は、そうした多層の情報をまとめて扱う前提に合っています。一方で、単純な死活監視や台数の少ないサーバー室では、ここまでの解釈性が必須でない場合もあります。導入価値が高いのは、GPU利用率の変動が大きく、原因切り分けに時間がかかる環境です。慎重に見るべきなのは、BMCやPDUの取得粒度が粗い、または欠損が多い現場です。
導入・検討時に確認したいこと
- BMC、ジョブスケジューラ、PDUの取得粒度が分単位の前提に合うか。
- 既存環境で欠損や時刻ずれがどの程度あるか。
- 弱いラベルしかない状態で、誤検知と見逃しのバランスをどう評価するか。
- 故障注入に相当する検証を、実機停止を伴わずにどう再現するか。
- アラートをエピソード化した後、運用手順にどう接続するか。
現時点で分かっていないこと
論文要約からは、実装の提供形態や商用製品としての利用条件は分かりません。また、どの規模のHPCクラスタまで安定して適用できるか、既存監視基盤との具体的な連携方法も明示されていません。日本の現場で使う場合の運用コストも、本文だけでは判断できません。
HPCやデータセンター運用では、検知精度だけでなく、アラートをどう解釈し現場で扱うかが重要です。既存監視の見直しや運用設計を考える際は、テレメトリの取り方や保守体制も含めて整理しておくと判断しやすくなります。
ITインフラの構築・保守をご検討の方へ
「自社の環境にはどんな構成・保守体制が合うのか」お悩みではありませんか。貴社の現場課題に合わせたご提案をいたします。まずはご相談からお気軽にどうぞ。
出典: arXiv (cs.DC)