
KVキャッシュを3層で配分する「KVStream」、LLM推論の待ち時間を短縮
公開日:2026年10月27日
3行解説
- KVStreamは、LLM推論時のKVキャッシュ読み出しを3つのストレージ階層に分散する手法です。
- node-local NVMe、共有ファイルシステム、クラウドストアを前提に、帯域をまとめて使う設計です。
- LMCache比で最大1.49倍のスループット向上、TTFTは最大6.1倍改善と報告されています。
ニュースの概要
arXivに、KVStream: Adaptive Parallel Storage Management for KV Caching in Large-Scale LLM Servingという論文が2026年10月22日に投稿されました。著者はAvinash Maurya氏ら6人です。対象は、長文コンテキストを扱うLLMの推論基盤で、agentic、coding、document系のワークロードを想定しています。論文では、KVキャッシュがGPUメモリやホストメモリを超えると、前置き部分の再利用のための読み出しが推論の重要経路に入ると説明しています。
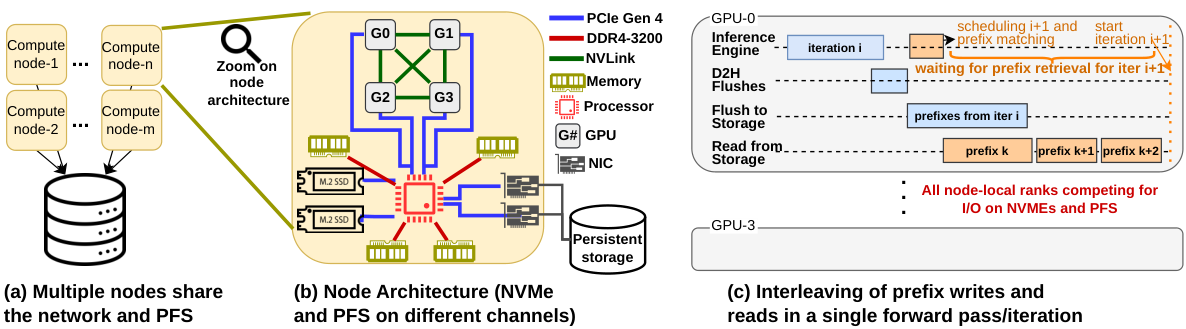
提案手法のKVStreamは、読み出しをまとめて処理し、書き込みをフォワードパスの後ろに回し、各チャンクを全階層に複製したうえで、空いた階層が次の未読チャンクを自律的に取得する方式です。評価は4モデル、6データセット、最大128GPUで行われ、LMCacheに組み込んで検証されています。
何が新しいのか
新しい点は、KVキャッシュの読み出しを「どの階層が空いているか」に応じて配分し、予測や手動チューニングなしで帯域を使い切ることを狙っている点です。従来の静的な分割では、階層ごとの帯域差が変動すると性能が落ちやすいのに対し、KVStreamは次に読むチャンクを動的に割り当てます。論文の性能モデルでは、これにより集約帯域の上限に近づけるとしています。
GPU・ホスト・ストレージの各階層を固定配分せず、空き状況に応じて次の読み出し先を変える流れです。
評価結果としては、LMCache比で最大1.49倍のオフラインスループット向上、バースト到着時の平均TTFTを最大6.1倍短縮とされています。つまり、この研究は単に「速い」だけでなく、負荷が急に増える場面で応答開始の遅れを抑える方向に効く可能性があります。
グリットアーツ編集部の分析
この論文で重要なのは、node-local NVMe、parallel file system、cloud file storeの3階層を前提にしている点です。LLM基盤では、GPUを増やしてもKVキャッシュの読み出しが詰まるとTTFTが悪化します。KVStreamは、その詰まりを「どの階層にどれだけ流すか」で解く発想なので、GPU増設だけでは改善しにくい現場に向いています。一方で、ホストメモリに収まる規模や再利用が少ない負荷では、論文自身が効果が薄い可能性を示しています。
導入判断では、性能の平均値よりも、帯域が揺れるときにどこまで崩れないかを見るべきです。静的な分割で十分な環境なら複雑さは増えませんが、バーストが多い本番系では、TTFTの改善が利用者体験に直結します。研究段階ではありますが、ストレージ階層をまたぐ推論基盤の設計を見直す材料としては実務的です。
日本の現場で考えると
日本の企業でLLMを使う場合、推論基盤はGPUサーバだけでなく、共有ストレージやクラウド接続の設計まで含めて考える必要があります。特に、問い合わせ対応、社内文書検索、コード補助のように、短時間にアクセスが集中する用途では、TTFTの悪化がそのまま体感品質の低下になります。KVStreamのような方式は、こうしたバースト負荷がある環境で検討しやすい一方、安定した小規模利用では優先度が下がるでしょう。
また、既存のLMCache運用を前提にしている点も重要です。新しい基盤をゼロから作るというより、既存の推論スタックにどう差し込むかが論点になります。日本の現場では、GPU台数の増減、NVMeの容量設計、共有ストレージの帯域、障害時の切り戻しを合わせて確認しないと、理論上の性能が出ても運用で崩れる可能性があります。
導入・検討時に確認したいこと
- 既存の推論基盤がLMCache前提か、差し替えや併用が必要か。
- node-local NVMe、共有ファイルシステム、クラウドストアの帯域差がどの程度あるか。
- バースト到着時のTTFTと、平常時のスループットの両方をどう測るか。
- ホストメモリに収まるケースや再利用が少ないケースで効果が薄くないか。
- 運用中にストレージ構成を変えた場合、性能モデルどおりに動くか。
現時点で分かっていないこと
論文要旨だけでは、実運用での導入難易度や、既存環境への組み込み手順の詳細は分かりません。また、どの規模のワークロードで効果が出やすいか、障害時の挙動や運用コストがどうなるかも未確認です。評価は4モデル・6データセット・最大128GPUですが、特定業種の本番環境で同じ改善幅が出るとは限りません。
LLM基盤では、GPUだけでなくストレージ階層の設計が応答速度を左右します。既存環境でどこが詰まりやすいかを整理したい場合は、構成見直しの観点から検討する価値があります。
ITインフラの構築・保守をご検討の方へ
「自社の環境にはどんな構成・保守体制が合うのか」お悩みではありませんか。貴社の現場課題に合わせたご提案をいたします。まずはご相談からお気軽にどうぞ。
出典: arXiv (cs.DC)