
MoE推論の通信をスイッチ側へ INC-MoEがvLLMの待ち時間短縮を示す
公開日:2026年10月29日
3行解説
- INC-MoEは、MoE推論のdispatchとcombineをスイッチ側で処理する方式です。
- vLLMのMoE層に差し替え可能で、通信と計算を重ねて待ち時間を減らします。
- 4ノードの評価では、TTFTを最大33%短縮し、スループットを最大50%向上しました。
ニュースの概要
arXivに、INC-MoEという研究論文が公開されました。公開日は2026年10月26日で、分野は分散・並列・クラスタ計算です。論文は、expert-parallelなMixture-of-Experts(MoE)推論では、各トークンを担当するエキスパートへ送るdispatchと、結果を戻すcombineが通信の要所になり、マルチノード環境では遅延の大きな原因になると説明しています。
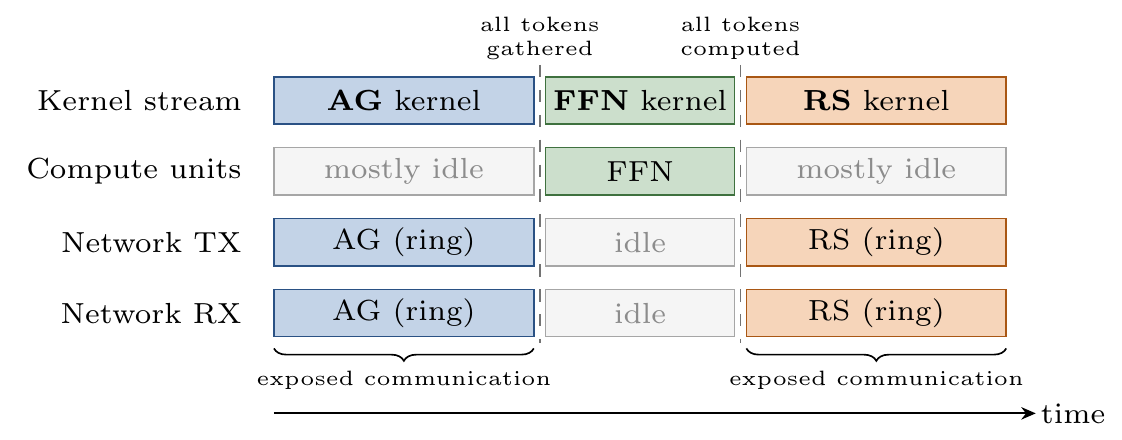
提案手法は、dispatchをスイッチ側のmulticastによるin-network AllGather、combineをスイッチ側のreductionによるin-network ReduceScatterで処理します。さらに、これらの通信とエキスパート計算を1つのpersistent kernel内で重ねる構成です。評価では、vLLMのMoE層の置き換えとして動作し、4ノード相当のエミュレーション環境で性能を検証しています。
何が新しいのか
新しさは、MoE推論の通信を「GPU間で回す」だけでなく、スイッチ側にオフロードして計算と同時進行させる点にあります。論文では、dispatchとcombineを別々の通信処理として扱うのではなく、ネットワークの両方向の帯域を使い分けながら同時に進める設計を示しています。これにより、帯域が詰まりやすいマルチノード構成で、通信時間を短くできるとしています。
INC-MoEは通信をスイッチ側へ寄せ、計算と重ねて進める。
論文中では、ring-based collectivesと比べて、帯域律速の通信時間を理論上33%〜43%削減できるとしています。実測でも、OLMoEのprefillで4-way expert parallelismを使った場合、time to first token(TTFT)を最大33%短縮し、throughputを最大50%向上させたと報告しています。単なるアルゴリズム改善ではなく、ネットワークとGPUの役割分担を変える提案だといえます。
グリットアーツ編集部の分析
この論文で重要なのは、4ノードのエミュレーションでTTFTとスループットの両方を改善した点です。MoE推論では、ユーザー体感に効くのはTTFT、処理量に効くのはスループットです。両方が改善しているため、単なるベンチマーク上の見栄えではなく、待ち時間と処理能力の両面で意味がある可能性があります。
一方で、評価は実機のスイッチではなく、専用アクセラレータでINCスイッチをエミュレートした構成です。そのため、実運用ではスイッチ機能の有無、ネットワーク機器の対応、既存のvLLM基盤への組み込みや障害時の切り戻しが導入難易度を左右します。GPUを増やす前に通信を詰める発想としては有効ですが、すべての環境でそのまま性能が出るとは限りません。
日本の現場で考えると
日本でこの方式を検討するなら、まず対象は複数ノードにまたがるMoE推論基盤です。単一ノードで完結する構成や、通信量が小さいモデルでは、スイッチ側オフロードの効果は限定的になりやすいでしょう。逆に、GPUを増やしても通信が先に詰まる環境では、ノード追加の前に見直す価値があります。
現場では、ネットワーク機器がin-network collectivesに対応できるか、既存の推論基盤とどこまで互換性があるかが要点です。persistent kernelを使うため、GPUの占有時間や他処理との共存も確認が必要です。障害時に従来のcollective pathへ戻せるかどうかも、運用設計では重要になります。
導入・検討時に確認したいこと
- 使うスイッチやネットワークが、multicastやreductionの処理に対応できるか。
- 既存のvLLMやMoE実装に、どの範囲まで差し替え可能か。
- persistent kernelによるGPU占有が、他の推論処理やバッチ処理に影響しないか。
- 障害時に従来の通信経路へ切り戻せるか。
- TTFT改善とスループット改善のどちらを優先指標にするか。
現時点で分かっていないこと
論文だけでは、実機スイッチでの動作条件や、商用ネットワーク機器への適用範囲は分かりません。また、4ノード評価以外の大規模構成で同じ改善率が出るかも未確認です。運用コストや導入工数についても、本文からは判断できません。
MoE推論のように、計算より通信が先に詰まる構成では、GPUだけでなくネットワーク設計も性能を左右します。既存基盤でどこがボトルネックになるかを整理したい場合は、構成見直しの観点から検討する価値があります。
ITインフラの構築・保守をご検討の方へ
「自社の環境にはどんな構成・保守体制が合うのか」お悩みではありませんか。貴社の現場課題に合わせたご提案をいたします。まずはご相談からお気軽にどうぞ。
出典: arXiv (cs.DC)