
IBMの30,920件分析で見えた、LLM微調整とサーバーレスAIの運用課題
公開日:2026年11月3日
3行解説
- IBM関連の研究で、LLM微調整の30,920件の実験結果を分析した。
- 1〜32GPU構成、4種類のGPU、成功・失敗の両方を対象にしている。
- RoCEの有無で効率差が出るなど、運用面の論点が具体化した。
ニュースの概要
arXivに2026年10月29日付で、Radu Nicolae氏ら3名による技術報告「LLM Fine-Tuning Workloads: Characterization, Challenges, and Opportunities for Serverless AI」が公開されました。分野は分散・並列・クラスタ計算です。本文では、サーバーレス環境でのLLM微調整が広がる一方、提供側に性能低下、資源の無駄、設定ミスによるサービス失敗といった運用負荷が移ると説明しています。そこでIBMのLLMFineTuningBenchを使い、4種類のGPUと1〜32GPU構成での挙動を調べています。
何が新しいのか
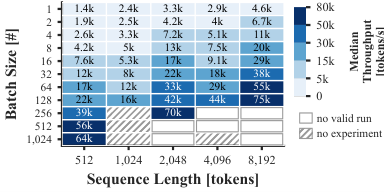
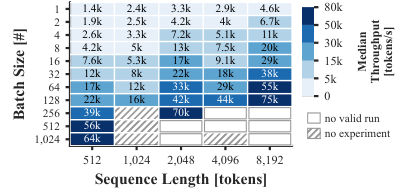
この報告の新しさは、LLM微調整を「理論上どう動くか」ではなく、30,920件の実験データで成功・失敗を含めて観察した点にあります。特に、バッチサイズやGPU構成によって、実行できるかどうか自体が大きく変わることを示しました。小さいバッチサイズ(16〜64)でも失敗率は52%で、最大バッチサイズ(1,024)では95%まで上がっています。性能面では、スループットはバッチサイズに対して対数的に増え、同一ノード内ではほぼ線形にスケールする一方、ノードをまたぐとネットワーク最適化の有無が効いてきます。
バッチサイズや分散方法で、失敗率と効率が同時に変わることを整理した図です。
さらに、RoCEを使うとインターノードの効率が0.72まで上がる一方、使わない場合は0.26でした。アプリ側の工夫であるFast MoEの1.7倍より、RoCEの最大2.9倍の改善のほうが大きいとされています。つまり、LLM微調整ではモデルの工夫だけでなく、ネットワークやクラスタ設計の影響が非常に大きいことが分かります。
グリットアーツ編集部の分析
この報告で重要なのは、「GPUを増やせば速くなる」だけでは済まないと示した点です。1〜32GPUの範囲で、同一ノード内はほぼ線形に伸びる一方、ノードをまたぐとRoCEの有無で効率が大きく変わります。これは、サーバーレスAI基盤を検討する企業にとって、GPU調達だけでなくネットワーク設計とジョブ配置が性能を左右することを意味します。失敗率が最大95%に達する条件もあるため、PoCでは性能測定だけでなく、失敗しやすい設定を先に除外する設計が必要です。
日本の現場で考えると
日本でこの種の基盤を使う場合、まず確認したいのは、既存のデータセンターやサーバー室でRoCE相当の低遅延ネットワークを前提にできるかどうかです。GPUを増やしても、ネットワークが追いつかなければ効率は落ちます。また、サーバーレス運用では利用部門が設定を持ち込むため、誤ったバッチサイズや分散設定がそのまま失敗や資源浪費につながりやすいです。向いているのは、学習ジョブが多く、構成の標準化を進められる組織です。逆に、都度異なる設定を手作業で回す現場では、運用ルールの整備が先になります。
導入・検討時に確認したいこと
- 対象モデルとバッチサイズごとの失敗率を、事前にどこまで再現できるか。
- 1ノード内とノード間で、どの構成が最も効率的か。
- RoCEなどのネットワーク最適化を既存環境で使えるか。
- GPUの種類ごとに、スループットと安定性の差がどれだけあるか。
- 失敗時の再実行や切り分けを、運用側で自動化できるか。
現時点で分かっていないこと
この報告だけでは、実運用のSLAやコスト、商用サービスとしての提供条件は分かりません。また、どの業種・どのモデルサイズで最も効果が出るかも、本文からは限定できません。IBMのデータセットを使っているため、他社環境で同じ傾向が出るかは追加検証が必要です。
LLMの微調整を本番運用に近い形で回すには、GPUだけでなくネットワークや失敗時の切り分けも重要です。基盤設計や検証計画を考える際は、こうした運用論点を前提に整理しておくと判断しやすくなります。
ITインフラの構築・保守をご検討の方へ
「自社の環境にはどんな構成・保守体制が合うのか」お悩みではありませんか。貴社の現場課題に合わせたご提案をいたします。まずはご相談からお気軽にどうぞ。
出典: arXiv (cs.DC)