
AnchorKVが示すKVキャッシュ再構成の新手法 設定ファイルだけで適用可否を見極めやすく
公開日:2026年11月4日
3行解説
- AnchorKVは、TransformerのKVキャッシュを損失なく再構成する手法を提案した。
- モデル設定ファイルだけで、適用の境界となる間隔を見積もれるとしている。
- CPU、CUDA、Ascend NPUで検証し、出力の一致と性能差を確認した。
ニュースの概要
arXivに2026年10月28日付で公開された論文「AnchorKV」は、Hao Li氏ら4人の研究チームが発表した。対象はTransformerの推論時に使うKVキャッシュで、残差ストリームを使ってキャッシュを再構成する方法を提案している。論文では、残差アンカーの間隔を調整できる「storage-replay spectrum」を示し、モデルの設定ファイルだけから採用の境界を計算できるとしている。CPU、CUDA、Ascend NPUの各バックエンドで評価し、bit-exactな再構成を確認した。
何が新しいのか
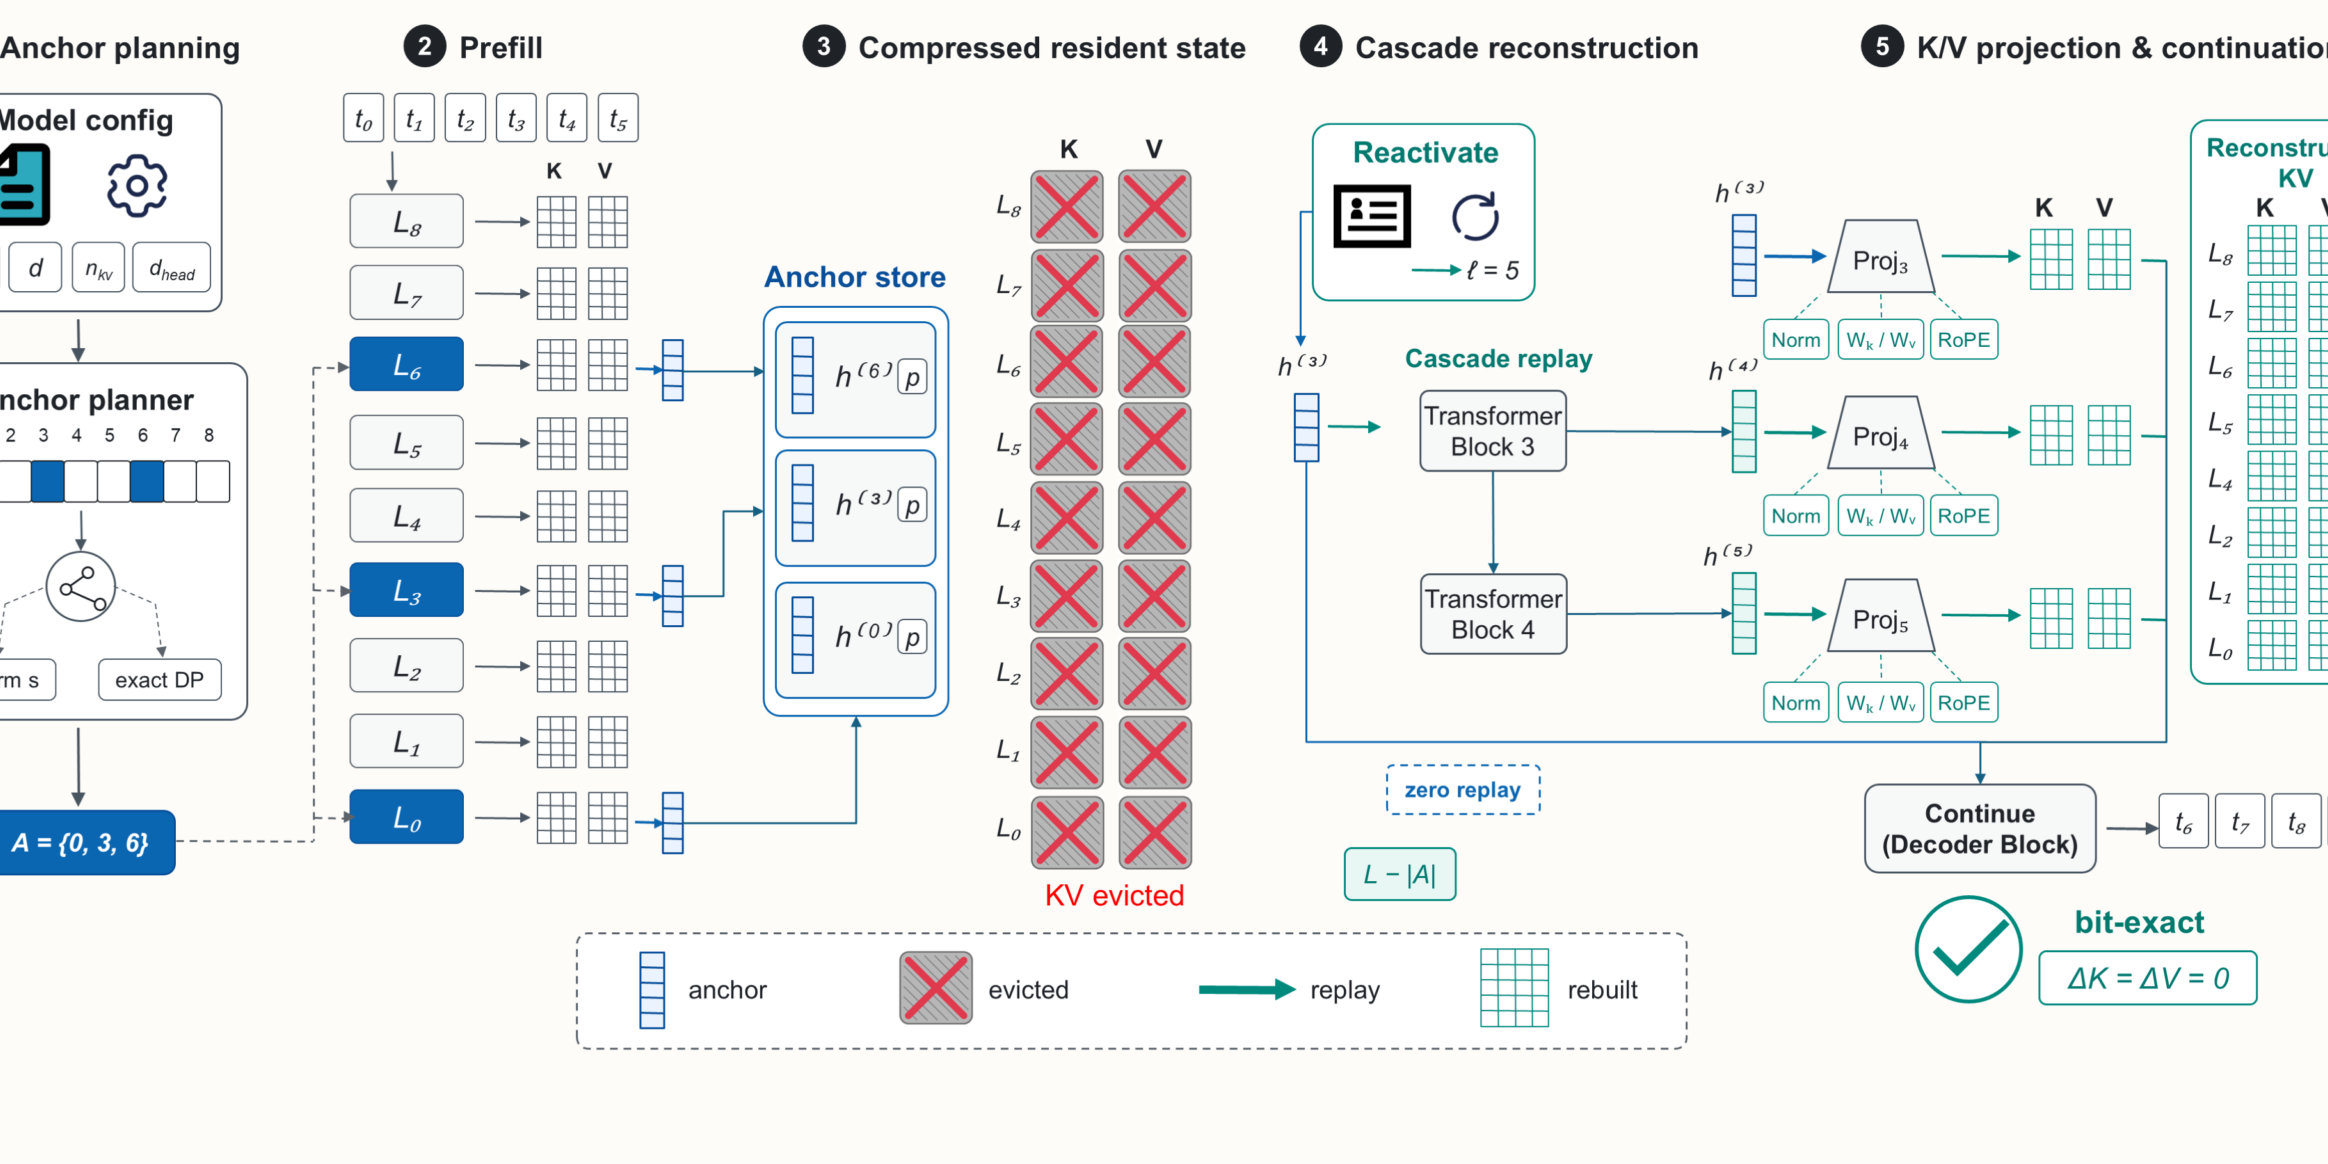
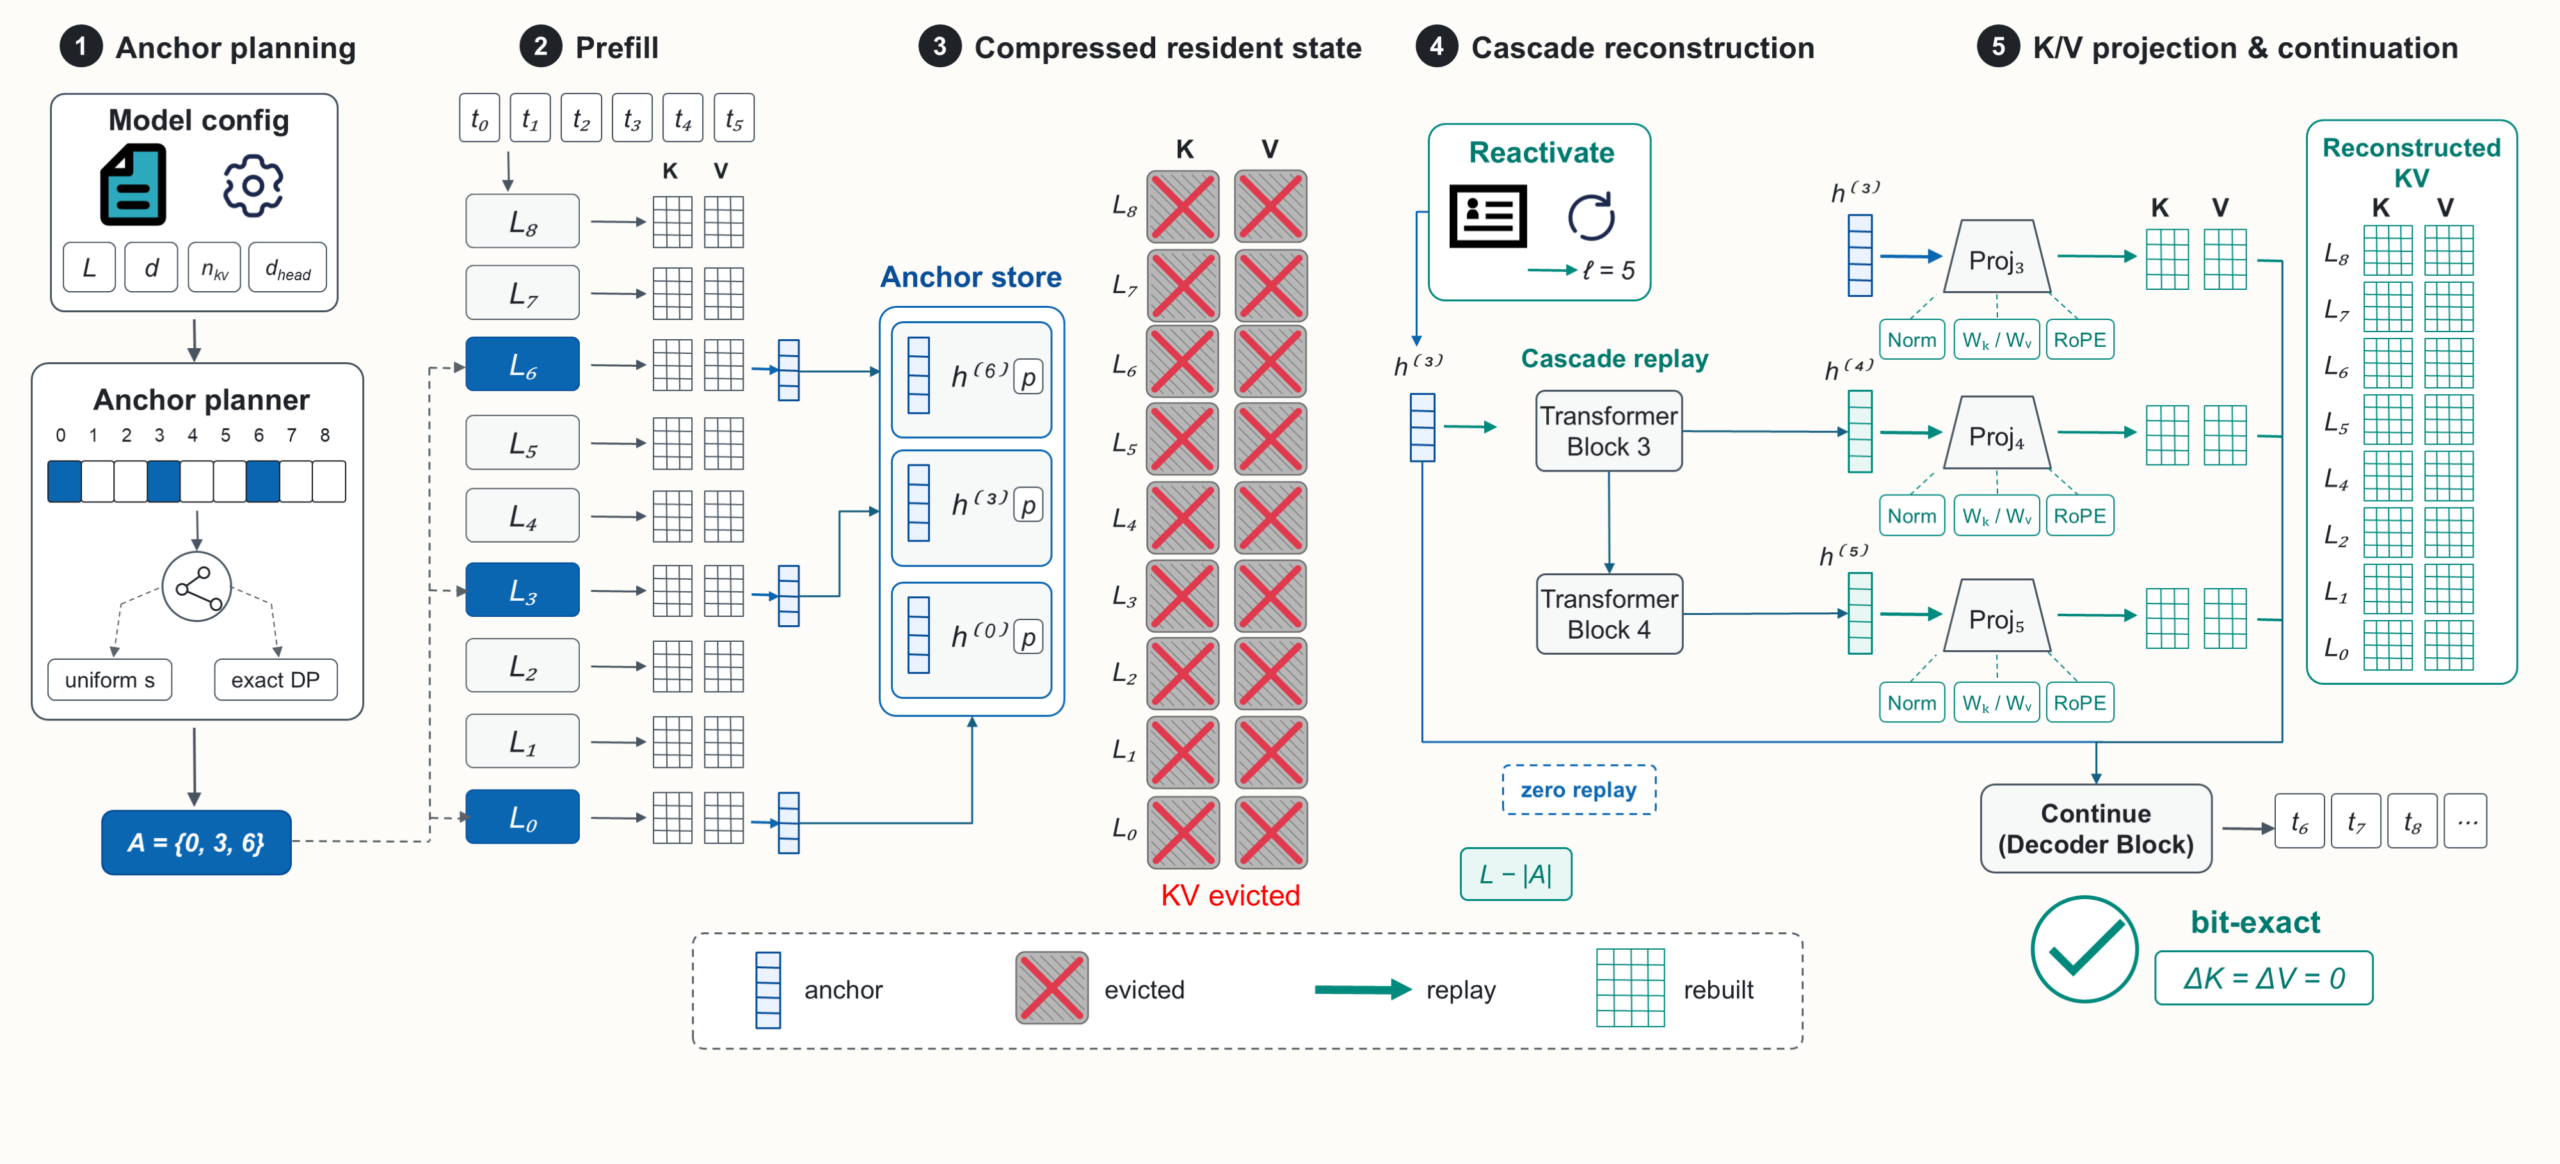
新しい点は、KVキャッシュを「全部保持する」か「全部再計算する」かの二択ではなく、その中間を取れるようにしたことです。AnchorKVは、残差アンカーを一定間隔で残しながら再構成するため、メモリ節約と再計算コストの両方を調整できます。論文では、再構成の計算量をO(Ls)からO(L)へ下げられるとし、4kコンテキストでは最大16.3倍高速、32kコンテキストでは全KVを再活性化できるセッション容量が5.78〜54.0倍になったとしています。
保存量を抑えつつ、推論時に必要なキャッシュを戻す流れを示す。
また、論文は損失ありの外部キャッシュ手法と比べ、フルキャッシュの検索性能や質問応答スコアを保てるとしています。つまり、単にメモリを減らすだけでなく、出力の忠実性を落とさないことを狙った設計です。さらに、最初の保存間隔をモデル設定ファイルだけで算出できるため、実装前の見積もりがしやすい点も特徴です。
グリットアーツ編集部の分析
実務上のポイントは、「設定ファイルだけで break-even spacing を計算できる」と明記されていることです。これは、モデルを動かしてから試行錯誤するのではなく、導入前に適用可否を机上で絞り込みやすいことを意味します。一方で、論文の評価はCPU、CUDA、Ascend NPUの検証環境に依存しているため、実際の本番環境で同じ効果が出るかは別途確認が必要です。特に、レイテンシ重視の対話系と、長文コンテキストを多用する用途では、最適なアンカー間隔が変わる可能性があります。
日本の現場で考えると
日本の生成AI基盤では、GPUメモリの制約が先に効くケースが多く、KVキャッシュ削減はサーバー台数や同時接続数の設計に影響します。今回の手法は、出力品質を落とさずに容量を増やせる可能性があるため、社内チャットボットや長文検索、質問応答のような用途と相性がよさそうです。一方で、モデル構成が複雑な場合や、スライディングウィンドウを含む構成では、論文が示すようにアンカー配置の最適化が必要になります。既存の推論基盤にそのまま入れるのではなく、実運用のコンテキスト長と応答時間を前提に見極めるべきです。
導入・検討時に確認したいこと
- 対象モデルの設定ファイルだけで、break-even spacing を算出できるか。
- 自社の推論基盤がCPU、CUDA、Ascend NPUのどれに当たるか。
- 4kや32kなど、実運用で使うコンテキスト長で効果が出るか。
- bit-exactな再構成が必要な業務で、出力の一致を確認できるか。
- スライディングウィンドウや非一様な再構成需要がある場合に、配置最適化が必要か。
現時点で分かっていないこと
論文本文だけでは、商用推論基盤への実装難易度や運用コストは分かりません。また、どのモデルでどの程度の効果が出るかは、アーキテクチャやコンテキスト長によって変わります。実運用での障害対応や監視方法も、今回の情報からは確認できません。
生成AI基盤では、メモリ削減と応答遅延、出力品質のどこで折り合いをつけるかが重要です。既存環境での検証条件を整理したい場合は、推論基盤の設計観点から見直す価値があります。
ITインフラの構築・保守をご検討の方へ
「自社の環境にはどんな構成・保守体制が合うのか」お悩みではありませんか。貴社の現場課題に合わせたご提案をいたします。まずはご相談からお気軽にどうぞ。
出典: arXiv (cs.AR)