
WorldBridgeが示す、動画と少量デモでロボット汎化を高める新手法
公開日:2026年11月3日
3行解説
- WorldBridgeは、ロボットの動画予測と行動生成を分けて学習する手法です。
- RoboTwin 2.0では、動画追加と少量の行動デモで未知タスクの成功率が上がりました。
- 異種軌跡の標準化や時間スケールの異なる記憶機構も組み込みました。
ニュースの概要
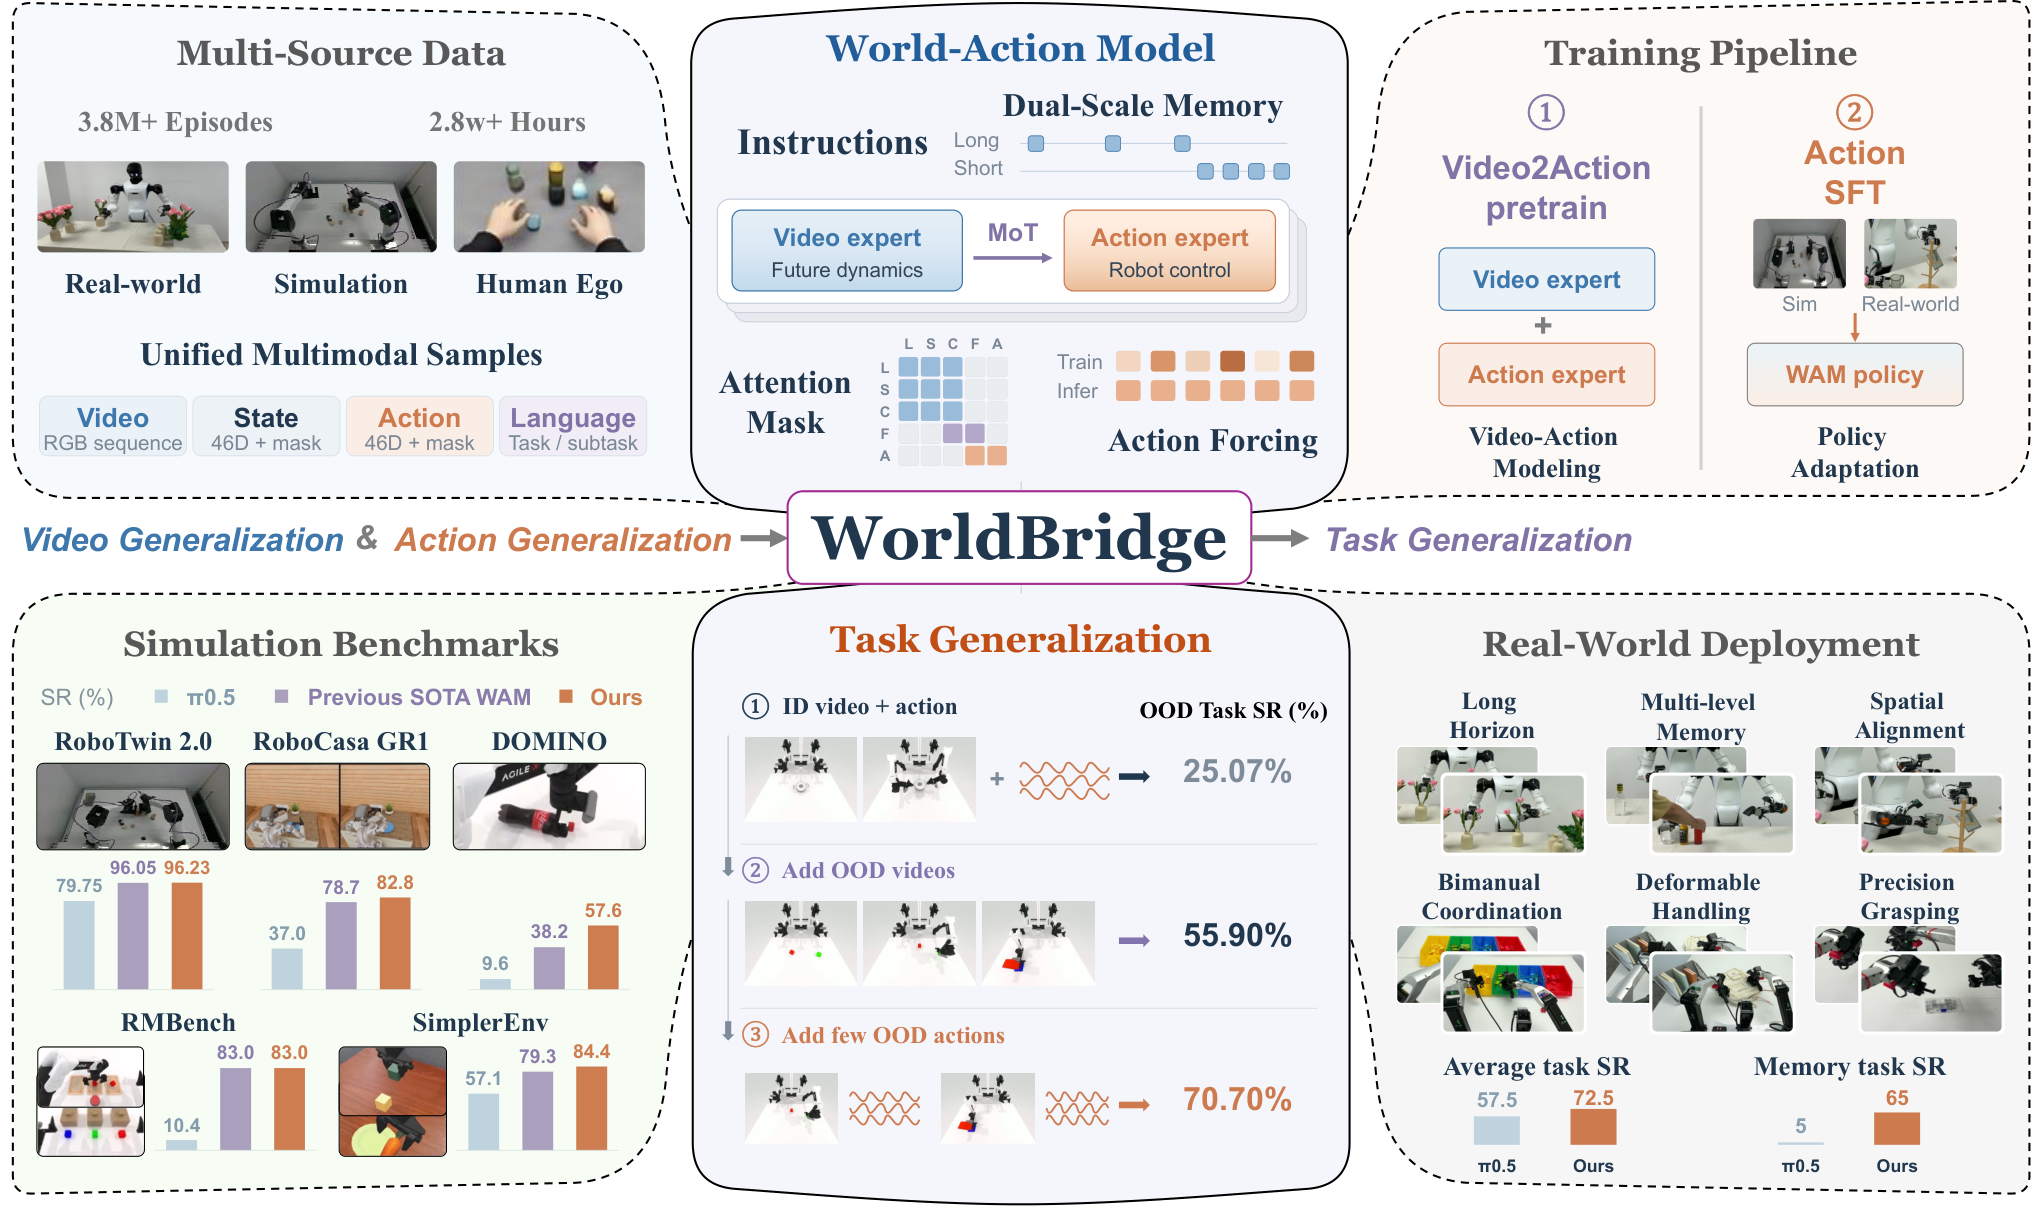
米arXivに2026年10月29日付で投稿された論文「WorldBridge: Bridging Video and Action for Task Generalization in World Action Models」は、ロボットが物理環境で新しい作業にどこまで対応できるかを扱っています。著者らは、World Action Models(WAMs)において、動画の一般化と行動の一般化を別々の能力として検証しました。RoboTwin 2.0など複数の操作ベンチマークで評価し、動画や行動ラベルの与え方が未知タスクの成功率にどう影響するかを示しています。
何が新しいのか
この論文の新しさは、ロボット学習を「見た目の変化を予測する部分」と「その予測を実行可能な動きに変える部分」に分けて考えた点です。RoboTwin 2.0では、既存の学習範囲内の動画・行動だけだと未知タスク成功率は25.07%でしたが、未知タスクの動画を追加すると55.90%まで上がり、さらに各タスクに1件だけ行動ラベル付きデモを足すと70.70%まで改善しました。つまり、動画の広いカバー範囲と、少量でも実行データを入れることの両方が効く、という整理です。
動画だけでなく、少量の実デモを足して実行可能性を高める流れを示しています。
さらに、WorldBridgeはstructured attention、joint flow matching、2つの時間スケールのvisual memory、action forcingを組み合わせています。加えて、異なるロボット軌跡や手元視点のデータを標準化・フィルタリングする統一パイプラインも持ちます。単に精度を上げるだけでなく、ばらつきのある学習データをどう扱うかまで含めて設計しているのが特徴です。
グリットアーツ編集部の分析
注目すべきは、動画だけでは25.07%だった成功率が、動画追加で55.90%、さらに各タスク1件の行動デモで70.70%まで上がった点です。これは、現場導入で「大量の実演データが必須」とは限らない一方、完全に動画だけで済むとも言い切れないことを示します。実務では、まず動画で広く候補を学ばせ、最後に少量の実機デモで詰める構成が現実的とみられます。ただし、データ整備とラベル付けの手間は残るため、学習精度だけでなく運用負荷も評価対象にすべきです。
日本の現場で考えると
日本の製造・物流現場で考えると、この手法は「作業手順が似ているが、品種や置き方が少しずつ違う」用途に向きやすいです。たとえば、ピッキング、整列、単純な組立補助のように、動画で作業の流れを集めやすい現場では相性がよい可能性があります。一方で、照明条件や治具、対象物のばらつきが大きい現場では、動画だけでは足りず、実機デモの追加が必要になりやすいでしょう。既存ロボットの制御系や安全柵との整合も、導入時の重要な論点です。
導入・検討時に確認したいこと
- 対象タスクごとに、動画だけで足りる範囲と行動デモが必要な範囲はどこか。
- 各タスク1件のデモで十分か、追加デモが必要か。
- 異種ロボット軌跡や手元視点データを、どの形式で標準化するのか。
- 学習時の前処理とフィルタリングに、どれだけ工数がかかるか。
- 未知タスクや環境変化に対して、どのベンチマーク条件で再評価するか。
現時点で分かっていないこと
論文本文だけでは、実運用で必要なデモ収集量の上限や、学習・推論に必要な計算資源は分かりません。また、特定の産業ロボットや実工場環境での長期運用結果も示されていません。どの程度の環境差まで同じ設計で吸収できるかも、追加検証が必要です。
ロボットの学習基盤は、モデル性能だけでなくデータ整備や検証手順で実運用の難易度が変わります。現場導入を考えるなら、どこまでを動画で補い、どこから実デモが必要かを先に整理することが重要です。
ITインフラの構築・保守をご検討の方へ
「自社の環境にはどんな構成・保守体制が合うのか」お悩みではありませんか。貴社の現場課題に合わせたご提案をいたします。まずはご相談からお気軽にどうぞ。
出典: arXiv (cs.RO)